ИИ можно вырастить как ребенка — в реальном хаосе мира
Поворот в ML: учим модели на "мусорных"
лайках вместо чистых оценок
лайках вместо чистых оценок
Мы привыкли, что обучение
ИИ по человеческой обратной связи (RLHF) требует аккуратных, проверенных оценок людей-разметчиков. В реальности же
платформы — от соцсетей до медиа и маркетплейсов, — не выдают чистых ярлыков
“хорошо/плохо”: есть лишь шумные, смещённые сигналы (лайки, дочитывания, клики,
покупки), зависящие от контекста и масштаба аудитории.
ИИ по человеческой обратной связи (RLHF) требует аккуратных, проверенных оценок людей-разметчиков. В реальности же
платформы — от соцсетей до медиа и маркетплейсов, — не выдают чистых ярлыков
“хорошо/плохо”: есть лишь шумные, смещённые сигналы (лайки, дочитывания, клики,
покупки), зависящие от контекста и масштаба аудитории.
Авторы нового метода обучения [1] предлагают
способ принять этот шум в работу, а не прятаться от него: учить модели на непроверенных,
реальных сигналах (RLNVR), но
при этом аккуратно вычищать системные перекосы и стабилизировать обучение.
способ принять этот шум в работу, а не прятаться от него: учить модели на непроверенных,
реальных сигналах (RLNVR), но
при этом аккуратно вычищать системные перекосы и стабилизировать обучение.
Коротко говоря:
Бери сырой, шумный и бестолковый мир как он есть, нормируй очевидные
искажения, переноси сигнал по смысловому сходству и держи петлю обратной связи устойчивой.
Бери сырой, шумный и бестолковый мир как он есть, нормируй очевидные
искажения, переноси сигнал по смысловому сходству и держи петлю обратной связи устойчивой.
Звучит гениально
просто. Осталось понять следующее.
просто. Осталось понять следующее.
1.
Как это работает на практике (и почему это вообще возможно)?
Берём реальные, пусть и шумные, реакции людей; приводим их к честной шкале;
переносим опыт с лучших похожих случаев; и учим модель с простыми, но жёсткими
«поручнями», чтобы она не читерила.
Как это работает на практике (и почему это вообще возможно)?
Берём реальные, пусть и шумные, реакции людей; приводим их к честной шкале;
переносим опыт с лучших похожих случаев; и учим модель с простыми, но жёсткими
«поручнями», чтобы она не читерила.
2.
Если
получится, - что это будет значить для общества и для каждого из нас?
Мир обратных связей
заговорит громче. Сильно упростится обучение моделей и повысится «демократизация
RL». Но может восторжествовать
«закон Гудхарта для ИИ».
Если
получится, - что это будет значить для общества и для каждого из нас?
Мир обратных связей
заговорит громче. Сильно упростится обучение моделей и повысится «демократизация
RL». Но может восторжествовать
«закон Гудхарта для ИИ».
3.
Что
в сухом остатке
Предложен проект аккуратного
инженерного моста между сложной и непростой жизнью (напомню, - мой канал называется
@theworldisnoteasy😊) и петлями машинного обучения ИИ. Но мир
еще сложнее, и многое тут зависит уже не от кода, а от нас.
Что
в сухом остатке
Предложен проект аккуратного
инженерного моста между сложной и непростой жизнью (напомню, - мой канал называется
@theworldisnoteasy😊) и петлями машинного обучения ИИ. Но мир
еще сложнее, и многое тут зависит уже не от кода, а от нас.
Теперь подробней
Как это работает на практике (и почему это вообще
возможно)
возможно)
Несколько упрощая,
можно объяснить это простыми словами примерно так.
можно объяснить это простыми словами примерно так.
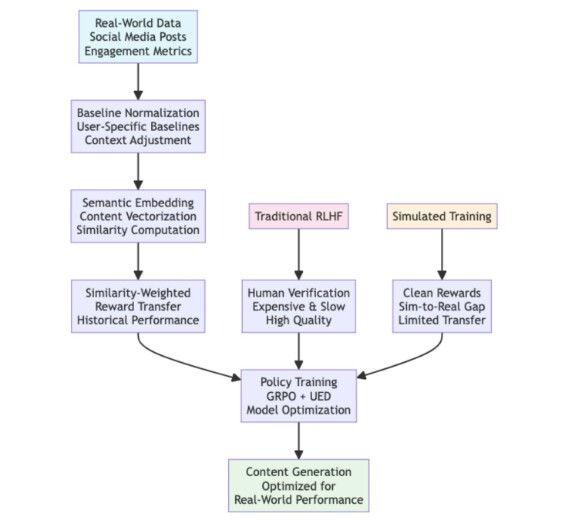
1) Выравниваем
«поле».
Сырые лайки и репосты нечестно сравнивать: у «звёзд» (инфлюенсеров, да и вообще
у любой медийной персоны) их по умолчанию больше. Поэтому сначала считаем не
«сколько собрал пост», а «насколько он лучше (или хуже) обычного для этого
автора». Пример: если у «звезды» обычно 1 000 лайков, а у новичка 20, то пост
звезды, начиная с 1100 лайков, и пост
новичка с 40+ лайков — считаем оба «выше своей нормы». Так сигнал становится
сравнимым.
«поле».
Сырые лайки и репосты нечестно сравнивать: у «звёзд» (инфлюенсеров, да и вообще
у любой медийной персоны) их по умолчанию больше. Поэтому сначала считаем не
«сколько собрал пост», а «насколько он лучше (или хуже) обычного для этого
автора». Пример: если у «звезды» обычно 1 000 лайков, а у новичка 20, то пост
звезды, начиная с 1100 лайков, и пост
новичка с 40+ лайков — считаем оба «выше своей нормы». Так сигнал становится
сравнимым.
2) Ищем
«самого похожего двойника».
У нового текста нет будущего — мы не знаем, как он «зайдёт». Выход: ищем в
прошлом самый близкий по смыслу пост (например, о той же ссылке/теме) и берём
его результат как ориентир. Причём ориентируемся на лучшего из похожих: «делай
как самый удачный из на тебя похожих». Это позволяет учиться даже там, где
прямых тематических аналогов нет.
«самого похожего двойника».
У нового текста нет будущего — мы не знаем, как он «зайдёт». Выход: ищем в
прошлом самый близкий по смыслу пост (например, о той же ссылке/теме) и берём
его результат как ориентир. Причём ориентируемся на лучшего из похожих: «делай
как самый удачный из на тебя похожих». Это позволяет учиться даже там, где
прямых тематических аналогов нет.
3) Ставим
«ограждения», чтобы модель не хитрила.
Как только даёшь метрику, её начинают «взламывать» — модель может уйти в
однообразные безопасные ответы или пустой кликбейт (закон Гудхарта и здесь не
спит). Поэтому в обучение вшивают простые страховки:
«ограждения», чтобы модель не хитрила.
Как только даёшь метрику, её начинают «взламывать» — модель может уйти в
однообразные безопасные ответы или пустой кликбейт (закон Гудхарта и здесь не
спит). Поэтому в обучение вшивают простые страховки:
- не поощрять повтор одного и того же
текста; - слегка «привязывать» стиль к
исходному (чтобы не унесло в спам); - время от времени «встряхивать»
задачи, чтобы модель не залипала на одном трюке.
Идея проста: повышаем качество, но не даём скатиться в дешёвые трюки.
4) Собираем
всё вместе в прототипе.
Авторы сделали «Walter» —небольшого
и умного автора коротких постов. Его учили на данных соцсети: считали
нормированный успех постов (репосты ценнее, затем ответы, затем лайки), искали
«смысловых двойников», брали у них лучший результат как подсказку и крутили
обучение с «ограждениями». На выходе — тексты стали живее и меньше пустых
хештегов.
всё вместе в прототипе.
Авторы сделали «Walter» —небольшого
и умного автора коротких постов. Его учили на данных соцсети: считали
нормированный успех постов (репосты ценнее, затем ответы, затем лайки), искали
«смысловых двойников», брали у них лучший результат как подсказку и крутили
обучение с «ограждениями». На выходе — тексты стали живее и меньше пустых
хештегов.
5) Почему это
вообще работает.
вообще работает.
- В такой системе есть хорошие «измерители смысла» —
эмбеддинги: они позволяют надёжно находить похожие тексты. - Даже шумные поведенческие сигналы
(лайки, дочитывания, репосты) всё же коррелируют с полезностью для людей —
если их правильно нормировать. - «Страховки» в обучении держат систему
в адекватном коридоре. - И главное: всё это уже можно
запускать на обычном «железе» — не нужны дата-центры, значит подобные
циклы обучения становятся доступными большим и маленьким командам.
Суммируя всё это
в одном предложении: берём реальные, пусть и шумные, реакции людей; приводим их
к честной шкале; переносим опыт с лучших похожих случаев; и учим модель с
простыми, но жёсткими «поручнями», чтобы она не читерила.
в одном предложении: берём реальные, пусть и шумные, реакции людей; приводим их
к честной шкале; переносим опыт с лучших похожих случаев; и учим модель с
простыми, но жёсткими «поручнями», чтобы она не читерила.
Если получится, — что это значит для общества и для
каждого из нас
каждого из нас
Мир обратных
связей заговорит громче. Если
раньше многие модели подгонялись под вкусы разметчиков - людей, то теперь они смогут
учиться на наших реальных действиях в реальном мире социальных медиа — кликах,
дочитываниях, сохранениях, отказах… Не на идеале, а на практике. Такие контуры
машинного обучения, как у «Walter», легко переносятся на письма и заголовки, образовательные задания,
продуктовые тексты, исследовательские анонсы: везде, где есть хоть какой-то
(пусть шумный) сигнал результата.
связей заговорит громче. Если
раньше многие модели подгонялись под вкусы разметчиков - людей, то теперь они смогут
учиться на наших реальных действиях в реальном мире социальных медиа — кликах,
дочитываниях, сохранениях, отказах… Не на идеале, а на практике. Такие контуры
машинного обучения, как у «Walter», легко переносятся на письма и заголовки, образовательные задания,
продуктовые тексты, исследовательские анонсы: везде, где есть хоть какой-то
(пусть шумный) сигнал результата.
Светлая
сторона. Контент станет
понятней и адресней; инструкции — полезней; обучение — под темп ученика.
Появится «демократизация RL»:
такие цикла можно крутить на ноутбуке, не дожидаясь, когда и если это сделают
корпоративные ИИ-киты.
сторона. Контент станет
понятней и адресней; инструкции — полезней; обучение — под темп ученика.
Появится «демократизация RL»:
такие цикла можно крутить на ноутбуке, не дожидаясь, когда и если это сделают
корпоративные ИИ-киты.
Тёмная
сторона. Чем доступнее
такие петли, тем шире «менеджериальный взрыв» метрик: организации начнут
измерять и оптимизировать всё — не всегда к лучшему. Алгоритмы будут более настойчиво
преследовать метрику, а не смыслы (если мы не найдем способ их сдерживать). А
шумные социальные сигналы — системно смещены (эффект Матфея, случайность
времени, вкусы «эхо-камер»). Неправильно поставленная цель – это, по сути,
неправильная культура. И как следствие в алгокогнитивной культуре может восторжествовать
«закон Гудхарта для ИИ».
сторона. Чем доступнее
такие петли, тем шире «менеджериальный взрыв» метрик: организации начнут
измерять и оптимизировать всё — не всегда к лучшему. Алгоритмы будут более настойчиво
преследовать метрику, а не смыслы (если мы не найдем способ их сдерживать). А
шумные социальные сигналы — системно смещены (эффект Матфея, случайность
времени, вкусы «эхо-камер»). Неправильно поставленная цель – это, по сути,
неправильная культура. И как следствие в алгокогнитивной культуре может восторжествовать
«закон Гудхарта для ИИ».
Что в сухом остатке
RLNVR — это не
очередной гигантский алгоритмический прорыв, а аккуратный инженерный мост между
сложной и непростой жизнью (напомню, что мой канал называется @theworldisnoteasy
😊) и петлями машинного обучения. Если на этом мосту
соблюсти правила — нормировать, переносить по смыслу, стабилизировать, не
давать «взламывать» — модели начнут учиться у нас без конвейера разметчиков.
очередной гигантский алгоритмический прорыв, а аккуратный инженерный мост между
сложной и непростой жизнью (напомню, что мой канал называется @theworldisnoteasy
😊) и петлями машинного обучения. Если на этом мосту
соблюсти правила — нормировать, переносить по смыслу, стабилизировать, не
давать «взламывать» — модели начнут учиться у нас без конвейера разметчиков.
Это значительно ускорит,
упростит и удешевит столь важный этап обучения моделей … Но и усилит все наши
слабости. Как и любой новый инструмент управления вниманием, RLNVR — это тест на зрелость инфраструктуры и
культурных норм. И тут многое зависит уже не от кода, а от нас.
упростит и удешевит столь важный этап обучения моделей … Но и усилит все наши
слабости. Как и любой новый инструмент управления вниманием, RLNVR — это тест на зрелость инфраструктуры и
культурных норм. И тут многое зависит уже не от кода, а от нас.
#ИИ
#МашинноеОбучение
#МашинноеОбучение
ии
машинноеобучение