
MiniMax H3 локально в ComfyUI - Полное руководство / часть 1
Всем привет 👋
2026 год продолжает нас радовать новыми моделями с открытым исходным кодом.
На этот раз речь пойдёт о MiniMax H3 — новой модели от создателей Hailuo. И модель да, действительно интересная, она умеет не только оживлять картинку, а одновременно генерирует и видео, и речь, музыку и разные звуковые эффекты. То есть теперь звук не приклеивается к готовому ролику отдельной моделью, а создаётся вместе с изображением и сразу синхронизируется с происходящим в кадре.
Причём запустить её можно не только на RTX 5090 или какой-нибудь серверной видеокарте, но и на RTX 3060 с 8 - 12 ГБ видеопамяти. Само собой, чудес не бывает и на 8 ГБ генерация будет медленной, но все же работает.
Официальная страница модели со всей информацией тут - MiniMaxAI / MiniMax-H3
🔹 Итак, что же умеет MiniMax H3?
Модель понимает сразу несколько видов входных данных:
- текст;
- изображения;
- видео;
- обычные звуковые файлы и образцы голоса.
На выходе мы получаем видео со стереозвуком 32 кГц. Модель работает с частотой 24 кадра в секунду, поддерживает ролики продолжительностью примерно от 4 до 15 секунд и разные форматы кадра: 16:9, 9:16, 1:1, 4:3 и другие. Русский язык входит в список официально поддерживаемых языков для диалогов.
Но самое интересное начинается при работе с референсами. Мы можем показать модели персонажа, дать пример движения из другого видео, отдельно загрузить голос, описать новую сцену и попросить собрать всё это в один ролик. Например: внешность взять с первой картинки, движение камеры — из видео, голос — из аудиофайла, а одежду, фон и происходящее уже описать в промпте.
🔹 Как MiniMax H3 работает?
Если сильно не углубляться в архитектуру, вся система состоит из нескольких частей:
Сначала большой энкодер Qwen3-VL-32B разбирает текст, изображения и остальные референсы. Затем H3 Omni Transformer одновременно создаёт латенты видео и звука. После этого отдельные Video VAE и Audio VAE декодируют их в изображение и стереодорожку.
Именно поэтому для запуска недостаточно скачать один файл модели. Нам понадобятся:
- основная diffusion-модель H3;
- текстовый и визуальный энкодер Qwen3-VL-32B;
- Video VAE;
- Audio VAE;
- при желании — Turbo LoRA.
🔹 Какие версии MiniMax H3 существуют?
Здесь легко запутаться, потому что FL2VA и Ref2VA — это не два режима внутри одного файла, а две отдельные модели.
FL2VA
Это основная и самая универсальная версия, с которой я бы советовал начинать.
- Не загружаем картинку — получаем Text to Video.
- Загружаем одну картинку — получаем обычное Image to Video, причём изображение можно назначить первым или последним кадром.
- Загружаем две картинки — одна становится первым кадром, вторая последним, а модель создаёт переход и всё происходящее между ними.
Для большинства обычных задач — оживить арт, сделать ролик по тексту или соединить начальный и конечный кадр — нужна именно FL2VA.
Ref2VA
Это версия для полноценной работы с референсами. Она позволяет передать модели персонажа, стиль, движение, положение камеры, исходное видео, голос или музыку.
Официально поддерживается до 9 изображений, до 3 видео и до 3 аудиофайлов, но общее количество файлов не должно превышать 12. Это уже вариант для более сложных сцен, сохранения внешности персонажа, переноса движения, замены окружения и генерации речи с опорой на голосовой референс.
🔹 Что означают BF16, INT8, FP8, W4A8 и GGUF?
BF16 — самые большие исходные версии. Полная модель занимает около 66 ГБ, а pruned BF16 — около 40 ГБ. Качество хорошее, но для обычных домашних видеокарт скачивать их особого смысла нет.
INT8 ConvRot — уменьшенная версия. Официальный pruned-файл занимает около 21 ГБ. Сейчас ComfyUI советует использовать именно INT8 ConvRot при наличии актуальной сборки с CUDA 13.
FP8 Scaled — тоже около 21 ГБ. Это запасной вариант, если INT8 ConvRot на конкретной видеокарте или сборке выдаёт ошибку, шум либо чёрное видео.
W4A8 — экспериментальная 4-битная версия от Kijai. FL2VA занимает около 12,5 ГБ, Ref2VA — около 11,8 ГБ. Для RTX 3060 это один из самых интересных вариантов, но требуется ComfyUI 0.31.0 или новее.
GGUF — самые компактные кванты. Например, Q2-модель занимает примерно 6,7 ГБ, Q3 — около 8,7 ГБ, Q4 — около 11,4 ГБ. Они позволяют сильнее выгружать веса в оперативную память и запускать H3 на видеокартах с 8 ГБ, но обычно работают медленнее и могут немного проигрывать старшим версиям в деталях, движении и звуке.
🔹 Какой модели скачать?
Если собираетесь генерировать видео по тексту и оживлять картинки — скачивайте только FL2VA. Ref2VA можно добавить позже, когда действительно понадобятся видео-, аудио- и голосовые референсы.
Официальные модели для ComfyUI:
1. Модель FL2VA или Ref2VA — папка ComfyUI/models/diffusion_models/
Оптимальный вариант:
minimax_h3_fl2va_pruned_int8_convrot.safetensors
Для референсов:
minimax_h3_ref2va_pruned_int8_convrot.safetensors
Если INT8 не работает, берём соответствующую версию pruned_fp8_scaled.
2. Энкодер — папка ComfyUI/models/text_encoders/
Несмотря на название NVFP4, этот вариант не требует видеокарту Blackwell и работает на более старых NVIDIA.
3. VAE — оба файла кладём в ComfyUI/models/vae/
🔹 Облегчённые модели для слабых видеокарт
W4A8 для ComfyUI 0.31.0 и новее:
GGUF для 8–12 ГБ VRAM:
Для 8 ГБ можно начать с:
minimax_h3_fl2va_pruned-Q2_K.gguf — около 6,7 ГБ;
qwen3vl_32b_minimax_h3-Q2_K_M.gguf — около 13,1 ГБ.
Для 12 ГБ уже можно попробовать Q3 или Q4, если хватает оперативной памяти и терпения. Для работы GGUF в ComfyUI добавляем ноду - ComfyUI-GGUF
🔹 Как установить и запустить MiniMax H3 в Comfy Desktop?
В актуальном ComfyUI поддержка H3 уже встроена, поэтому для обычного официального workflow отдельные пользовательские ноды не нужны.
- Открываем Comfy Desktop.
- Жмем - Update и обновляем ComfyUI Engine. Для официальных моделей нужна версия 0.30.0 или новее, а для W4A8 — 0.31.0 или новее.
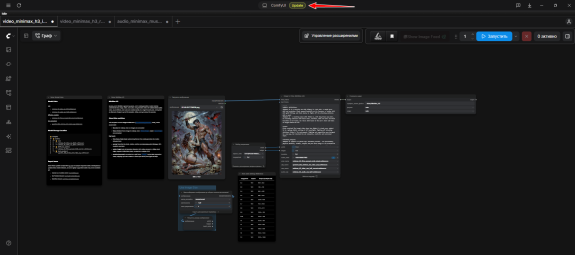
3. После запуска ComfyUI открываем Templates или Workflow Templates → Video.
Выбираем нужный вариант:
- MiniMax H3 T2V — видео по тексту;
- MiniMax H3 I2V — оживление картинки или первый/последний кадр;
- MiniMax H3 R2V — работа с изображениями, видео и аудиореференсами.

- Comfy Desktop покажет недостающие модели. Нажимаем Download — в Desktop-версии файлы автоматически скачиваются в нужные папки.
- В загрузчиках проверяем, что выбрана нужная модель, энкодер и оба VAE.
- Указываем формат кадра, разрешение, продолжительность, seed и пишем промпт. Размеры должны быть кратны 32.
- Нажимаем - Запустить.
Готовые официальные workflow и подробная инструкция:
🔹 Как пользоваться разными режимами?
Text to Video
Открываем T2V, ничего не подключаем к изображениям и описываем сцену, движение персонажей, камеру и звук в одном промпте.
Image to Video
Открываем I2V и подключаем изображение к first_frame. Если хотим, чтобы загруженная картинка стала финалом ролика, используем last_frame.
First and Last Frame
Подключаем сразу две картинки: начальную к first_frame, финальную к last_frame. В промпте описываем не сами изображения, а то, что должно произойти между ними.
Reference to Video
Открываем R2V, выбираем модель Ref2VA и загружаем нужные изображения, видео и аудио. В промпте прямо указываем, что именно нужно взять из каждого референса: внешность, стиль, движение, камеру, одежду, голос или музыку.
🔹 Что такое Turbo LoRA и как она работает?
Обычной MiniMax H3 требуется примерно 20 шагов. Turbo LoRA меняет траекторию денойзинга и позволяет получить результат за 4–8 шагов. По сути модель заранее «обучили сокращать дорогу», поэтому она делает меньше проходов и заметно быстрее генерирует видео вместе со звуком.
Скачать лору можно тут - LightX2V MiniMax H3 Turbo
Для FL2VA:
minimax_h3_fl2v_turbo_4step_v1.0_768p_comfyui_bf16.safetensors
minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors
Для Ref2VA:
minimax_h3_ref2v_turbo_4step_v0.1_comfyui_bf16.safetensors
LoRA кладём в:
ComfyUI/models/loras/
Что бы ее добавить в комфи, нужно в вашем воркфлоу добавить загрузчик - Lora model only и соединить его с моделью, смотри скриншот ниже 👇
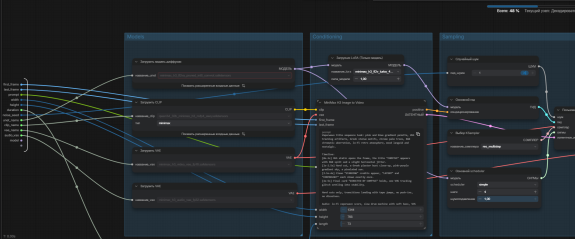
Версия на 4 шага работает быстрее, но на сложном движении может давать смазывание, двоение и менее стабильный звук. Вариант на 8 шагов медленнее, зато обычно лучше сохраняет лица, мелкие детали и движение.
Я бы начинал именно с 8-step, а 4-step оставил для быстрых тестов.
Есть ещё отдельная экспериментальная линия Turbo LoRA с собственными нодами - ComfyUI-MiniMax-H3-Turbo
Она добавляет ноды MiniMax-H3 Turbo LoRA и MiniMax-H3 Turbo Sampler.
Здесь автор рекомендует 4–8 шагов, а для сложного быстрого движения лучше использовать 6–8.
🔹 Настройки для RTX 3060 12 ГБ
Оптимальные настройки для 12 ГБ:
- minimax_h3_fl2va_pruned_w4a8_mixed.safetensors;
- qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors;
- обычные Video VAE FP16 и Audio VAE FP32;
- FL2VA Turbo LoRA на 8 шагов;
- разрешение 960×544 или ниже;
- 124 кадра, примерно 5 секунд при 24 FPS;
- batch size 1.
Можно сделать короткий тест в 640×384. Если всё работает, то поднимаем
выше.
🔹 Настройки для RTX 3060 8 ГБ
На 8 ГБ лучше использовать GGUF Q2 или W4A8:
- minimax_h3_fl2va_pruned-Q2_K.gguf;
- qwen3vl_32b_minimax_h3-Q2_K_M.gguf, энкодер держим на CPU;
- Video VAE FP16 и Audio VAE FP32;
- Turbo LoRA на 4 шага для тестов;
- разрешение 640×384;
- около 4–5 секунд;
- batch size 1;
- декодирование VAE по тайлам, если workflow это позволяет.
LoRA с GGUF пока считается экспериментальной возможностью ComfyUI-GGUF. Если Turbo LoRA не подключается или выдаёт ошибку, сначала проверьте этот же workflow без LoRA, либо переходите на W4A8.
После удачного теста можно попробовать Q3 или W4A8 и 8 шагов.
И ещё один важный момент
Для первого знакомства советую взять FL2VA W4A8, готовый MiniMax H3 Easy workflow и Turbo LoRA на 8 шагов - по соотношению качества, размера моделей и сложности запуска.
А Ref2VA уже можно оставить на следующий вечер, когда захочется подключить пять картинок, два видео, музыку и окончательно превратить ComfyUI в схему управления космическим кораблём))
Если остались вопросы — пишите в комментариях.
Всем удачных генераций 😉✌
minimax h3

Aliya Ojoko
От души благодарю!
Aug 18 15:53 

1
GA3D / NORDART
Comment removed
Aug 18 19:18

Дмитрий Невский
GA3D / NORDART, так да, но вы же сами можете это сделать, этот способ подходит для любого рабочего процесса, или просто скопируйте ноду из одного воркфлоу и вставьте в нужный и все получится)
Aug 18 21:15

Alex Kuznetsov
А схема Lipsync для minimax есть?
Aug 21 09:16
Дмитрий Невский
Alex Kuznetsov, да, но я еще не пробовал -
https://github.com/Shrek3OnVH5/MiniMax-H3-NativeAudio-MusicVideo-Workflow?utm_source=chatgpt.com
сам рабочий процесс - https://github.com/Shrek3OnVH5/MiniMax-H3-NativeAudio-MusicVideo-Workflow/blob/master/workflows/MiniMaxH3_NativeAudio_MusicVideo_TEMPLATE.json
Aug 21 10:43 (changed)


